En mars 2025, j’avais raconté ici comment j’ai redéveloppé mon site avec React et CodeIgniter grâce à Grok 3, sans presque aucune expérience en React. La méthode tenait en quelques étapes : une poignée de prompts, puis des allers-retours quand quelque chose coinçait. Le résultat arrivait en quelques heures, même si « tout ne marchait pas du premier coup ».
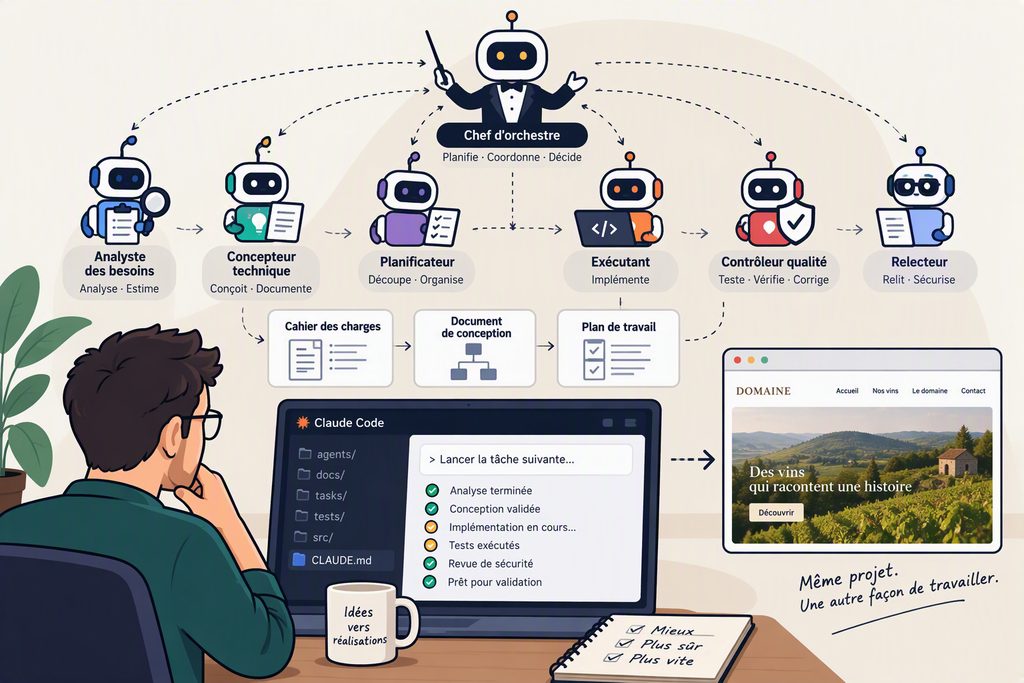
Aujourd’hui, je travaille un autre site de domaine viticole (PHP, CodeIgniter, MariaDB), et la façon de travailler avec l’IA n’a plus grand-chose à voir. On n’enchaîne plus les prompts dans une fenêtre de chat. J’utilise Claude Code avec une configuration qui organise une petite équipe virtuelle : des rôles, des documents et des points de contrôle. Ce billet se veut une suite logique du premier : ce qui a changé, et pourquoi.
Mars 2025 contre aujourd’hui :
| Mars 2025 | Aujourd’hui | |
|---|---|---|
| Outil | Grok 3 dans un chat, comparé à GPT-4o, Claude 3.5 et Copilot | Claude Code dans l’éditeur, avec accès direct au code |
| Méthode | Prompts itératifs : je demande, j’essaie, je relance | Un circuit : besoins, conception, plan, implémentation, revue |
| Qui pilote | Moi, à chaque échange | Un agent chef d’orchestre, et moi aux points de validation |
| Contexte fourni à l’IA | Ce que je colle dans le prompt | Le code, la configuration et des règles projet écrites une fois pour toutes |
| Vérification | Surtout à l’œil, au fil des essais | Tests automatiques, relecture du code et de la sécurité |
| Quand ça casse | Un nouveau prompt avec l’erreur | Une enquête, une contre-expertise, puis seulement une correction |
La différence de fond : en 2025, la qualité dépendait surtout de la réponse du modèle. Aujourd’hui, elle dépend surtout du cadre dans lequel il travaille.
Un chef d’orchestre et des spécialistes
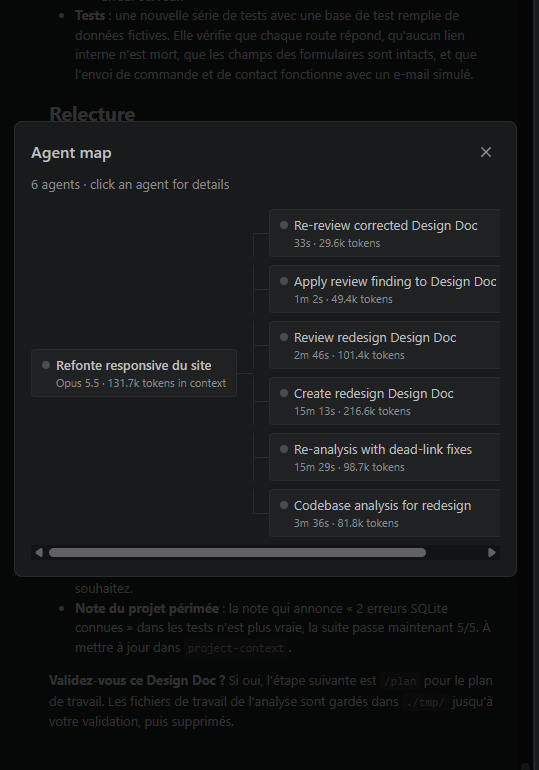
L’idée centrale : la session Claude principale ne code pas. Elle joue le chef de projet et confie chaque étape à un sous-agent spécialisé. Chaque sous-agent a un seul rôle, ses propres outils et un format de réponse imposé.
| Rôle | Ce qu’il fait |
|---|---|
| Analyste des besoins | Mesure ce que la demande touche dans le code et ce qu’elle va coûter |
| Concepteur technique | Rédige le document de conception |
| Planificateur | Découpe la conception en tâches |
| Exécutant | Implémente une tâche, rien de plus |
| Contrôleur qualité | Lance les tests et les vérifications, corrige ce qui casse |
| Relecteurs | Relisent le code et la sécurité à la fin |
Le chef d’orchestre dit quoi faire et où, jamais comment. Il donne à l’exécutant un fichier de tâche, pas une liste de lignes à modifier. Chaque spécialiste repart d’un contexte propre, ce qui évite qu’une longue conversation finisse par tout mélanger.
Toutes les demandes ne méritent pas ce circuit complet. Le chef d’orchestre classe d’abord la demande : petite, moyenne ou grande. Une petite correction passe directement à l’implémentation ; une grosse fonctionnalité traverse toutes les étapes. Il existe aussi un mode « Lite », celui que j’utilise, qui réduit le nombre d’agents appelés sans supprimer les validations humaines.
Des documents comme garde-fous
Pour une demande moyenne ou grande, rien ne se code avant que trois documents soient écrits et validés par un humain :
- Le cahier des charges : ce que l’utilisateur doit pouvoir faire, et ce qui est explicitement exclu.
- Le document de conception : comment on s’y prend, avec des critères d’acceptation vérifiables.
- Le plan de travail : la liste ordonnée des tâches.
Chaque document est relu par un agent relecteur, puis confronté au code réel par un agent vérificateur. Celui-ci attrape les affirmations du type « la fonction X existe déjà » quand elle n’existe pas.
L’intérêt n’est pas la paperasse. C’est d’avoir des points d’arrêt où je peux dire « non, pas comme ça » avant que cinquante fichiers soient modifiés. Le deuxième bénéfice de cette approche, c’est la reprise du développement avec des mini-étapes, par exemple le lendemain ou après une attente sur un quota de token expiré.
Pour diagnostiquer un bug : l’avocat du diable
Le piège classique avec une IA qui débogue, c’est qu’elle trouve une cause plausible, s’y accroche et corrige le symptôme. Le framework Claude Code sépare donc le diagnostic en trois rôles :
- L’enquêteur suit le chemin que prend l’exécution et liste tous les endroits où ça peut casser, preuves à l’appui.
- Le vérificateur essaie de démonter ce travail.
- Le solveur propose des corrections seulement une fois les causes confirmées.
Sur mon projet, il a d’ailleurs démonté une hypothèse qui me paraissait évidente : je pensais que le problème venait du contrôleur alors que la cause était finalement dans la configuration d’un composant tiers.
Pour chaque cause supposée, il joue l’avocat du diable :
- Et si ce comportement était en fait normal ?
- Quelle preuve contraire a-t-on oubliée ?
- Quelle hypothèse implicite est peut-être fausse ?
Il va aussi chercher dans une source que l’enquêteur n’a pas consultée : l’historique Git, la configuration ou la documentation officielle. Si la doc officielle contredit une hypothèse, celle-ci est automatiquement affaiblie. Enfin, il ne désigne pas un coupable unique : chaque cause est jugée séparément, car un bug en a souvent plusieurs.
Choisir comment implémenter : le plus petit design possible
Avant d’écrire du code, le concepteur suit une méthode en sept étapes. Le cœur tient en une question : quel est le design le plus simple qui atteint le résultat, et qu’est-ce qui oblige à en faire plus ?
Concrètement :
- Partir de l’existant. On trace le chemin le plus court qui livre le résultat avec ce que le code sait déjà faire.
- Chercher ce qui manque. On ne garde que les besoins que ce chemin ne couvre pas.
- Combler au moindre coût. Pour chaque manque, on essaie d’abord de réutiliser, de déduire d’une donnée existante ou de calculer à la volée. On n’ajoute une table, une option ou une classe qu’en dernier recours.
- Le test de soustraction. On retire chaque ajout, un par un, et on regarde si le résultat tient encore. Si oui, l’ajout disparaît.
Ce dernier test est redoutable contre la tendance des IA à « bien faire » : un service, une interface et un fichier de config pour afficher trois lignes. Chaque élément qui reste dans le design doit pouvoir dire quelle exigence casserait sans lui.
Les étapes suivantes sont plus classiques : comparer au moins deux stratégies, lister les risques avec une parade pour chacun, vérifier les contraintes (version de PHP, hébergeur, délais), puis consigner le choix et ses raisons dans le document de conception.
Par tranches ou par couches ?
Une fois le design fixé, il reste à décider dans quel ordre le construire. Il y a trois options :
| Approche | Principe | Quand la choisir |
|---|---|---|
| Verticale | Une fonctionnalité complète à la fois, de la base de données à l’écran | Fonctionnalités peu dépendantes entre elles, utilisables dès qu’elles sont finies |
| Horizontale | Une couche à la fois : d’abord les données, puis la logique, puis l’affichage | Plusieurs fonctionnalités reposent sur un socle commun qui doit être solide |
| Hybride | Un mélange, phase par phase | Besoins encore flous, ou passage d’un prototype à la version finale |
Le critère de choix n’est pas l’effort. C’est le risque le plus faible et la vérification la plus rapide.
Chaque tâche vise aussi un niveau de preuve, du plus fort au plus faible :
- L1, ça marche pour de vrai : un visiteur peut utiliser la fonctionnalité.
- L2, les tests passent : de nouveaux tests couvrent le comportement.
- L3, ça compile : le code est valide, sans rien encore d’exécutable.
On vise toujours le niveau le plus haut possible. Une tâche validée seulement par « ça compile » doit avoir une bonne raison de l’être.
Ce que j’en retiens sur un petit site
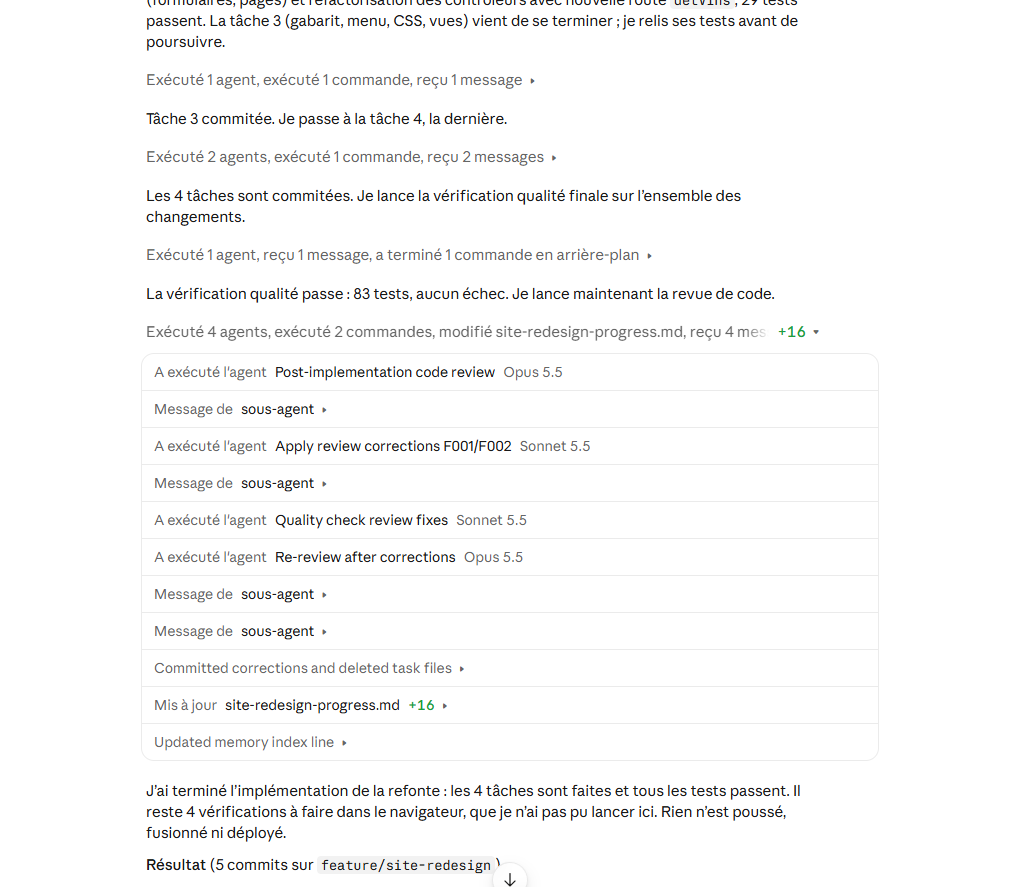
Le site sur lequel j’ai travaillé est simple : des pages rendues côté serveur, un formulaire de contact et de commande, pas d’application front séparée. Dans ce contexte, la méthode aboutit presque toujours au même choix : une approche verticale, une page à la fois, vérifiée en L1 par un test qui charge la vraie page.
Le circuit complet peut sembler lourd pour un site vitrine, d’où le mode Lite et le classement par taille. Mais trois idées valent la peine même sans le framework Claude Code:
- Séparer les rôles. Celui qui code n’est pas celui qui vérifie.
- Jouer l’avocat du diable sur chaque diagnostic avant de corriger.
- Faire le test de soustraction sur chaque ajout proposé par l’IA.
En 2025, l’IA m’avait permis d’aller vite sur une technologie que je ne maîtrisais pas. Un an et demi plus tard, elle n’est pas seulement plus intelligente : elle travaille dans un cadre qui la rend disciplinée. C’est exactement ce qui manquait à mes prompts itératifs.
Et au-delà du code ?
L’ingénierie logicielle est un terrain idéal pour ces méthodes agentiques. Le cadre y est déjà très carré : un langage strict, des tests automatisés, des standards partagés. Un agent peut y vérifier lui-même son travail, et un autre agent peut le contredire preuves à l’appui.
Quand on voit ce qu’on obtient dans ce cadre, on imagine sans peine le potentiel encore inexploité ailleurs. Je ne sais pas encore jusqu’où cette approche ira hors du développement logiciel, mais le parallèle me semble évident: dès qu’un métier dispose de règles explicites et de critères de validation clairs, on peut imaginer des agents spécialisés s’y répartir le travail.
Deux freins restent pourtant d’actualité :
- La souveraineté et la protection des données. Confier des documents clients, des dossiers médicaux ou des données internes à un modèle hébergé ailleurs pose toujours la question de savoir où vont ces données et qui y a accès.
- La perméabilité du domaine à l’IA. Un domaine sans règles écrites, sans moyen automatique de dire si un résultat est juste, ou peu disposé à changer ses pratiques, laisse peu de prise à ces méthodes.
Le code a eu de l’avance parce qu’il avait déjà fait ce travail de formalisation. Les autres domaines devront sans doute le faire à leur tour avant d’en tirer autant.
